Guía de optimización del rendimiento
Un análisis profundo de las técnicas de optimización del rendimiento web, desde Core Web Vitals hasta estrategias avanzadas de caché.
 James Mitchell
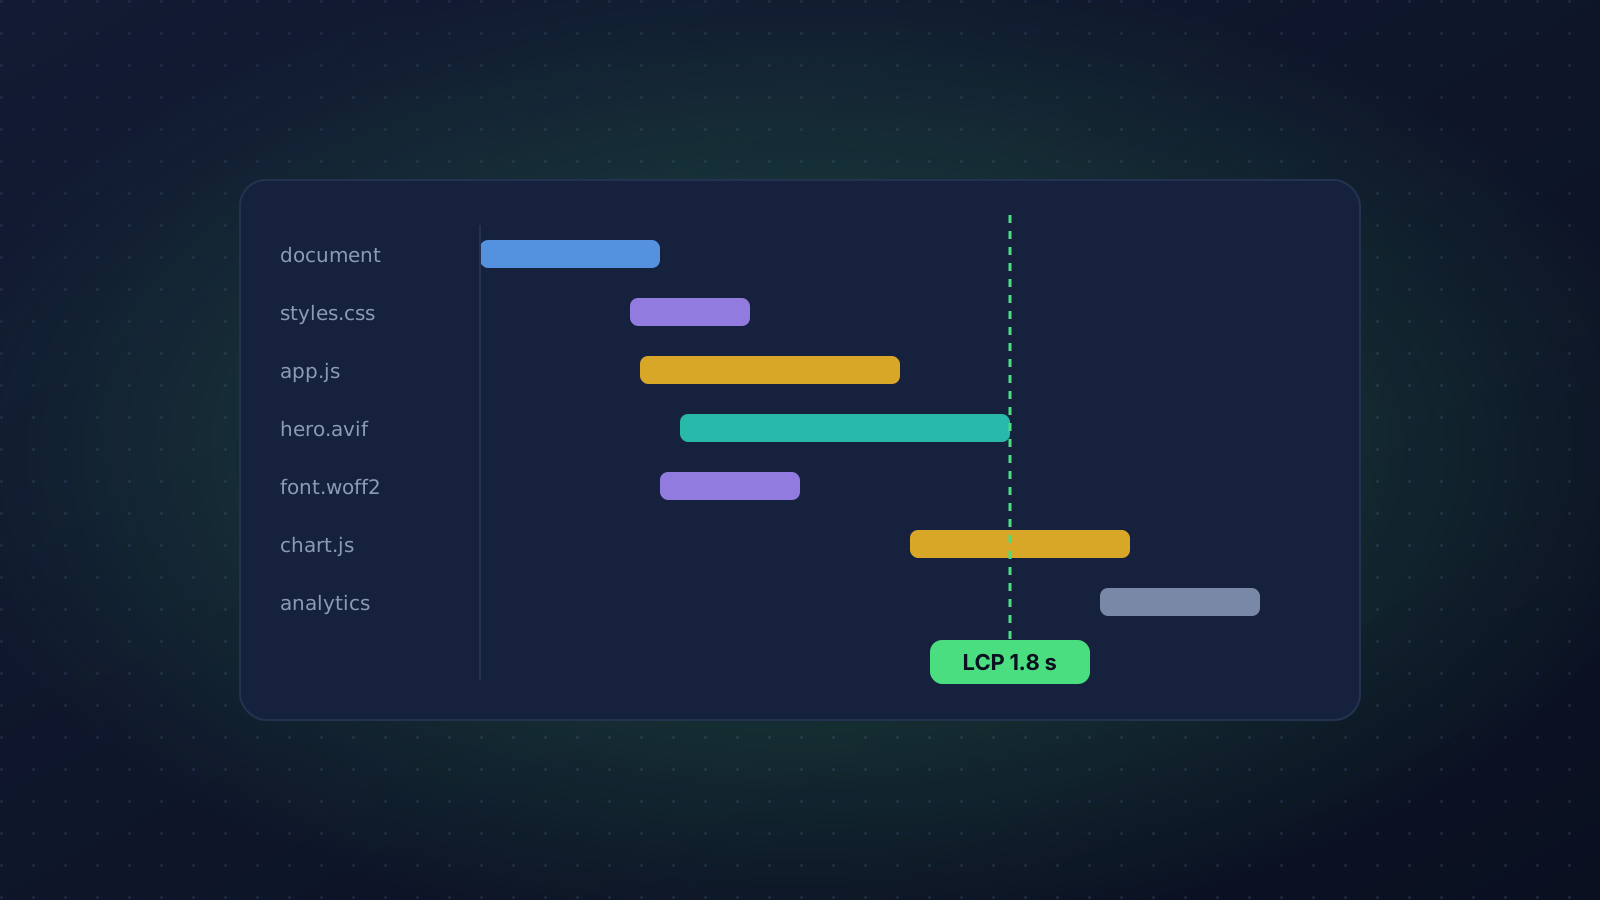
El rendimiento web influye directamente en la experiencia de usuario, las tasas de conversión y el posicionamiento en buscadores. Las páginas lentas pierden visitantes antes de que lleguen a ver su contenido, y cada segundo extra de espera erosiona la confianza. Así es como puede hacer que su sitio sea rápido y mantenerlo así.
Esta guía parte de la medición hacia afuera: primero decide qué significa “rápido”, después corrige a los mayores culpables (imágenes, fuentes, JavaScript) y, por último, consolida las mejoras con caché y monitorización.
Core Web Vitals
Las Core Web Vitals de Google (Largest Contentful Paint, LCP; Interaction to Next Paint, INP; y Cumulative Layout Shift, CLS) proporcionan referencias medibles de la experiencia de usuario. Apunte a un LCP inferior a 2,5 segundos, un INP inferior a 200 milisegundos y un CLS inferior a 0,1. INP sustituyó a First Input Delay (FID) como Core Web Vital en marzo de 2024, y es una métrica mucho más estricta: FID solo medía el retraso antes de procesar la primera interacción, mientras que INP considera la latencia de las interacciones a lo largo de toda la visita.
Los umbrales se evalúan en el percentil 75 de las cargas de página, por separado para móvil y escritorio. Ese detalle importa. Una página que es rápida en su portátil de desarrollo con el Wi-Fi de la oficina puede seguir fallando si una cuarta parte de sus visitantes reales usa teléfonos Android de gama media en una red congestionada.
Lo que cada métrica le dice realmente
- LCP mide cuándo termina de renderizarse la imagen o el bloque de texto más grande del viewport. Suele ser una imagen hero, un encabezado o un párrafo extenso. Un LCP deficiente se debe casi siempre a una respuesta lenta del servidor, a CSS y JavaScript que bloquean el renderizado o a una imagen hero que el navegador descubre demasiado tarde.
- INP mide la rapidez con la que la página responde visualmente después de un clic, un toque o una pulsación de tecla. Un INP deficiente casi siempre significa que el hilo principal está ocupado: tareas largas de JavaScript, una hidratación pesada o manejadores de eventos costosos.
- CLS mide el movimiento inesperado del contenido visible. Los culpables habituales son imágenes y contenido incrustado sin dimensiones, fuentes web que se intercambian con métricas distintas y banners o anuncios inyectados encima del contenido existente.
Datos de laboratorio frente a datos de campo
Las herramientas de laboratorio como Lighthouse ejecutan una única carga sintética en un dispositivo simulado. Son excelentes para depurar y para detectar regresiones en un pull request, pero no pueden medir el INP directamente porque nadie interactúa con la página. Los datos de campo, recopilados de visitantes reales, son en los que se basa realmente la evaluación de las Core Web Vitals. Use los datos de laboratorio para encontrar problemas y los datos de campo para decidir qué problemas importan.
Empiece por el servidor
Ningún ajuste del front-end puede ocultar un primer byte lento. El Time to First Byte (TTFB) no es una Core Web Vital, pero está justo delante del LCP: el navegador no puede empezar a renderizar hasta que llega el HTML.
- Prerenderice lo que pueda. La generación estática sirve el HTML directamente desde una CDN sin ida y vuelta al origen. Para las páginas que realmente necesitan datos por solicitud, almacene en caché la salida renderizada en el edge con una vida útil corta en lugar de renderizar cada solicitud desde cero.
- Haga streaming del HTML. Cuando el renderizado en el servidor sea inevitable, envíe pronto el head del documento para que el navegador pueda empezar a descargar CSS y fuentes mientras el body todavía se está generando.
- Evite las cadenas de redirecciones. Cada redirección es un viaje de ida y vuelta completo antes de que cargue cualquier contenido. Enlace directamente a las URL canónicas y mantenga coherentes las reglas de barra final y de
www. - Active los protocolos modernos y la compresión. HTTP/2 o HTTP/3 y la compresión Brotli o gzip para los recursos de texto son lo mínimo exigible a cualquier hosting o CDN serio.
Optimización de imágenes
Las imágenes siguen siendo lo que más contribuye al peso de la página en la mayoría de los sitios. Use formatos modernos como WebP y AVIF con alternativas adecuadas. Implemente imágenes responsive con srcset para servir imágenes del tamaño apropiado en cada dispositivo. Cargue de forma diferida las imágenes que quedan por debajo del pliegue con el atributo nativo loading="lazy".
Una imagen responsive bien construida tiene este aspecto:
<img
  src="/images/dashboard-800.webp"
  srcset="/images/dashboard-400.webp 400w,
          /images/dashboard-800.webp 800w,
          /images/dashboard-1600.webp 1600w"
  sizes="(min-width: 1024px) 50vw, 100vw"
  width="1600"
  height="900"
  alt="Revenue dashboard showing monthly trends"
  loading="lazy"
  decoding="async"
/>
Los atributos width y height permiten al navegador reservar la relación de aspecto correcta antes de que se descargue el archivo, lo que elimina una fuente habitual de desplazamiento del layout. El atributo sizes indica al navegador con qué ancho se renderizará la imagen para que pueda elegir el candidato adecuado más pequeño de srcset.
Trate la imagen LCP de otra manera
La carga diferida es la opción equivocada para la imagen con más probabilidades de ser su elemento LCP. Una imagen hero diferida espera al layout antes de empezar a descargarse, lo que retrasa directamente el LCP. Para la imagen hero:
- Elimine
loading="lazy". - Añada
fetchpriority="high"para que el navegador la descargue antes que otras imágenes. - Asegúrese de que se pueda descubrir en el HTML inicial, y no definida como fondo CSS o inyectada mediante JavaScript.
- Si tiene que venir del CSS o de un componente que carga tarde, añada un
<link rel="preload" as="image">en el head del documento.
Si usa Astro, los componentes integrados <Image /> y <Picture /> generan formatos optimizados, dimensiones y valores de srcset en tiempo de compilación, lo que elimina la mayor parte del trabajo manual.
Fuentes sin parpadeo
Las fuentes web afectan sobre todo al LCP y al CLS. Una fuente que bloquea el renderizado del texto retrasa el LCP cuando el elemento LCP es texto, y una fuente de respaldo que se intercambia por una fuente web con métricas distintas provoca desplazamiento del layout.
- Aloje sus fuentes en su propio servidor para que lleguen desde el mismo origen y la misma conexión que la página, evitando una búsqueda DNS y un handshake TLS adicionales.
- Cree subconjuntos de las fuentes con los juegos de caracteres que realmente usa. Un subconjunto solo latino ocupa una fracción de un archivo multilingüe completo.
- Use WOFF2 exclusivamente; todos los navegadores modernos lo admiten.
- Precargue solo los uno o dos archivos de fuente que se usan por encima del pliegue.
- Ajuste las métricas de la fuente de respaldo con los descriptores
size-adjust,ascent-overrideydescent-overridepara que el intercambio sea prácticamente invisible.
@font-face {
  font-family: "Inter Fallback";
  src: local("Arial");
  size-adjust: 107%;
  ascent-override: 90%;
}

body {
  font-family: "Inter", "Inter Fallback", system-ui, sans-serif;
}
Los valores exactos de ajuste dependen de la pareja de fuentes; varias herramientas open source pueden calcularlos por usted.
Code splitting
Envíe solo el JavaScript que una página realmente necesita. Frameworks como Astro lo gestionan automáticamente mediante la arquitectura de islas, pero en aplicaciones con mucha lógica en el cliente, las importaciones dinámicas y la división por rutas reducen considerablemente el tamaño del bundle inicial.
Los bytes son solo la mitad del coste. El JavaScript también tiene que analizarse, compilarse y ejecutarse en el hilo principal, y en un teléfono de gama media ese trabajo puede tardar varias veces más que en la máquina de un desarrollador. Por eso los bundles grandes se traducen en un INP deficiente, y no solo en cargas lentas.
Cargue el código interactivo cuando se necesite
Aplace todo lo que no sea necesario para la primera interacción. Una librería de gráficos que se usa en un modal no pertenece al bundle inicial:
const openReport = async () => {
  const { renderChart } = await import("./charts/revenue-chart");
  renderChart(document.querySelector("#report")!);
};

button.addEventListener("click", openReport);
En Astro, elija la directiva de hidratación de forma deliberada. client:load hidrata de inmediato, client:idle espera a que el navegador esté inactivo y client:visible espera a que el componente entre en la vista. Un widget de comentarios al final de un artículo casi nunca necesita client:load.
Audite sus dependencias
Ejecute un analizador de bundles en cada compilación de producción y busque a los sospechosos habituales: una librería de utilidades completa importada para una sola función, librerías de fechas que empaquetan todos los idiomas, copias duplicadas del mismo paquete en versiones distintas y polyfills para navegadores que ya no soporta. Sustituir una sola dependencia pesada a menudo ahorra más que semanas de microoptimización.
Mantenga libre el hilo principal
Los problemas de INP son problemas del hilo principal. Cualquier tarea que dure más de 50 milisegundos es una tarea larga y, mientras se ejecuta, el navegador no puede responder a la entrada del usuario.
- Divida las tareas largas. Separe los bucles grandes y las rutinas de inicialización en fragmentos y ceda el control al navegador entre ellos.
scheduler.yield()está disponible en los navegadores basados en Chromium y en Firefox; detecte si existe y recurra asetTimeouten los demás. - Haga menos en los manejadores de eventos. Actualice la UI de inmediato y aplace después las llamadas de analítica, la persistencia y el trabajo no visible.
- Evite el layout thrashing. Leer propiedades de layout como
offsetHeightdespués de escribir estilos fuerza un layout síncrono. Agrupe las lecturas antes de las escrituras. - Saque el cálculo pesado del hilo principal. El análisis de grandes cargas JSON, el filtrado de conjuntos de datos grandes o el procesamiento de imágenes pueden ejecutarse en un Web Worker.
- Vigile los scripts de terceros. Los gestores de etiquetas, los widgets de chat y las herramientas de pruebas A/B causan con frecuencia las peores tareas largas de una página. Cárguelos cuando la página ya sea interactiva y cuestione si cada uno sigue compensando su coste.
async function processInChunks<T>(items: T[], work: (item: T) => void) {
  for (let i = 0; i < items.length; i++) {
    work(items[i]!);
    if (i % 100 === 0) {
      await new Promise((resolve) => setTimeout(resolve, 0));
    }
  }
}
CSS y renderizado
Las hojas de estilo en el head del documento bloquean el renderizado por diseño. Normalmente es lo correcto, porque no se quiere un destello de contenido sin estilos, pero significa que el tamaño del CSS afecta directamente al LCP.
- Mantenga pequeño el CSS crítico. Los frameworks utility-first que generan solo las clases que usa ayudan en este punto.
- Evite
@importdentro de los archivos CSS, ya que crea cadenas de solicitudes secuenciales. - Use
content-visibility: autoen las secciones largas por debajo del pliegue para que el navegador pueda omitir el trabajo de renderizado hasta que se acerquen al viewport. Combínelo concontain-intrinsic-sizepara evitar saltos en la barra de desplazamiento. - Anime
transformyopacityen lugar de propiedades comotop,widthoheight, que provocan un layout en cada fotograma.
Estrategias de caché
Implemente un enfoque de caché por capas: caché del navegador para los recursos estáticos con cabeceras max-age largas, caché de CDN en el edge para el contenido distribuido geográficamente y caché de aplicación para los datos calculados o procedentes de la base de datos. Use cache-busting con hashes de contenido para los recursos inmutables.
Un conjunto práctico de cabeceras cubre la mayoría de los sitios:
# Recursos de compilación con hash: nunca cambian, caché para siempre
Cache-Control: public, max-age=31536000, immutable

# HTML: revalidar siempre para que los despliegues se vean de inmediato
Cache-Control: public, max-age=0, must-revalidate

# Respuestas de API semidinámicas: servir contenido obsoleto mientras se actualiza
Cache-Control: public, max-age=60, stale-while-revalidate=300
La regla clave es que solo los archivos con hash de contenido reciben vidas útiles largas. Si un nombre de archivo puede reutilizarse para contenido distinto, un max-age largo dejará a los usuarios atrapados en versiones antiguas después de un despliegue.
Caché en el edge y en la aplicación
En la capa de CDN, almacene en caché el HTML para los visitantes anónimos siempre que el contenido lo permita, y use surrogate keys o purgado por etiquetas si su proveedor lo admite, para que una actualización de contenido invalide exactamente las páginas a las que afecta. En la capa de aplicación, almacene en caché las consultas costosas y los fragmentos calculados, y sea explícito con la invalidación. Una caché sin una estrategia de invalidación clara acaba sirviendo datos incorrectos, lo cual es peor que servir datos lentos.
Acelere la página siguiente
Una vez que la página actual sea rápida, haga que la navegación parezca instantánea. Precargue las páginas siguientes probables al pasar el cursor o cuando los enlaces entren en el viewport; Astro incluye una función de prefetch configurable precisamente para esto. Asegúrese de que las páginas puedan aprovechar la caché de avance y retroceso del navegador evitando los manejadores unload y Cache-Control: no-store en el HTML que no lo necesite.
Defina un presupuesto de rendimiento
Las correcciones retroceden sin barreras de protección. Un presupuesto de rendimiento convierte “mantenerlo rápido” en cifras que pueden hacer fallar una compilación:
- Máximo de JavaScript enviado por ruta, comprimido.
- Peso total máximo de imágenes en las páginas de aterrizaje clave.
- Puntuación mínima de rendimiento en Lighthouse en páginas representativas.
- Objetivos de campo: LCP, INP y CLS en el percentil 75 dentro de los umbrales “buenos”.
Compruebe los presupuestos basados en laboratorio en su control local o de CI en cada cambio, y revise los objetivos de campo con una cadencia regular. Cuando se supere un presupuesto, trátelo como un test que falla: corrija la regresión o tome una decisión explícita y documentada de subir el límite.
Monitorización
La optimización del rendimiento no es una tarea puntual. Configure la monitorización de usuarios reales (RUM) para seguir las métricas de rendimiento de sesiones de usuarios reales. Los servicios comerciales de RUM o la librería JavaScript open source web-vitals ofrecen visibilidad continua sobre cómo experimentan su sitio los usuarios reales.
Recopilar datos de campo por su cuenta solo requiere unas pocas líneas:
import { onCLS, onINP, onLCP } from "web-vitals";

function send(metric: { name: string; value: number; id: string }) {
  navigator.sendBeacon("/api/vitals", JSON.stringify(metric));
}

onCLS(send);
onINP(send);
onLCP(send);
Segmente los datos por plantilla de página, tipo de dispositivo y conexión siempre que pueda. Un promedio de todo el sitio oculta la única plantilla que falla para la mayoría de sus visitantes. La versión con atribución de la librería también puede indicar qué elemento fue el candidato LCP y qué interacción provocó un INP lento, lo que convierte un vago “el sitio va lento” en una corrección concreta.
Reflexiones finales
Los sitios rápidos rara vez son el resultado de un único truco ingenioso. Surgen de una breve lista de hábitos aplicados con constancia: medir con datos de usuarios reales, servir el HTML rápidamente, priorizar el recurso LCP, enviar menos JavaScript, mantener libre el hilo principal, usar la caché de forma deliberada y proteger los resultados con un presupuesto. Empiece por la métrica que esté más lejos de su umbral en sus páginas más importantes, corrija la causa principal, vuelva a medir y repita.